

吴碧娥╱北美智权报 编辑部
全球人工智能加速由基础模型训练转向具备自主执行力的代理人工智能(Agentic AI),带动云端服务器运算架构深层变革,更引爆动态随机存取内存(DRAM)长达数年的结构性紧缩。随着云端巨头采购重心全面转向AI应用,推升服务器CPU出货与多核心配置快速膨胀,然而受限于原厂先进制程微缩瓶颈,位供给增幅显著放缓,使服务器DRAM供需缺口一路扩大并延续至2027年。在此波紧缩循环中,高带宽方案成为价值重塑的核心枢纽;内存原厂倾全力将逾七成晶圆产能重押于高带宽内存(HBM)与服务器高阶规格,合计霸占65%总供给,严重排挤传统消费性市场。从DDR5传输速率推升至HBM4单晶粒架构革新,内存已跃升为决定算力变现速度的关键战略底牌。
根据TrendForce预测,受惠于AI算力需求爆发与产品世代升级,2027年全球HBM产业营收将年增超过230%,一举突破2000亿美元大关[1]。在无尘室空间不足、半导体设备交期过长与先进封装产能受限的物理极限下,2028年前市场难以出现显著的有效供给增量,促使2027年HBM混合平均售价(Blended ASP)预估年增达121%至122%,来到每Gb 3.7美元的历史新高,高阶HBM4产品甚至将突破每Gb 5美元[2][3]。KeyBanc资本市场报告更指出,随着三星(Samsung)与SK海力士(SK hynix)的长期供应合约(LTA)换约价格陆续反映至市价,2027年第一季HBM价格将出现80%至100%的季增幅,单颗HBM4报价更将从2026年的500至550美元飙升至1400美元以上,带领内存原厂全面进入超额毛利时代[4][5]。
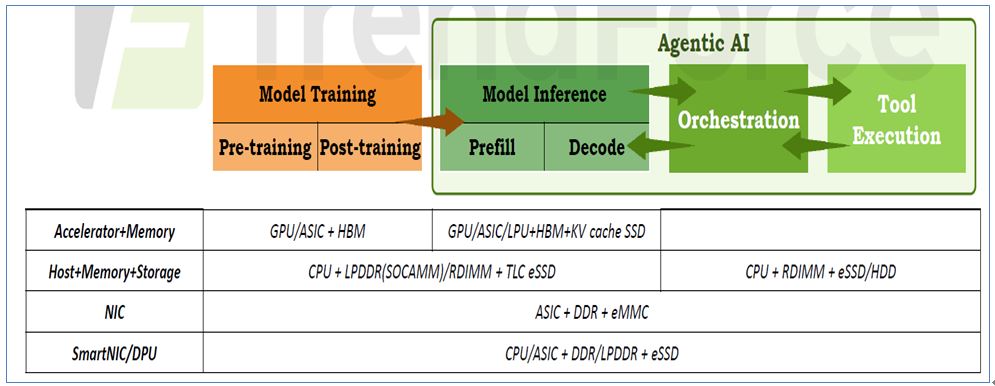
全球人工智能发展在历经数年的基础模型训练(Model Training)后,正迎来一场深刻的架构典范转移。集邦科技(TrendForce)半导体研究处资深分析师许家源在「2027科技产业大预测」研讨会上指出,自2025年底至2026年首季起,Agentic AI呈现爆发式成长,推动北美云端服务供货商(CSP)的采购核心全面倒向具备实质商业变现能力的AI应用。这项技术跃进不仅要求系统具备高效率的模型推论能力,更牵动了后续的多子代理编排(Orchestration)与工具调用执行(Tool Execution),促使服务器架构由过去侧重单一GPU丛集,全面扩展为结合高效能AI服务器与通用型服务器(General Server)的多层次协同体系。
许家源指出,典型的AI运算流程已由传统的预训练(Pre-training)与后训练(Post-training),延伸至长上下文推论的提示预填(Prefill)与输出译码(Decode),进而进入多代理协同的实体任务运行时间。在推论译码阶段,神经网络前馈运算(FFN)对延迟要求极为严苛,推动了LPU(语言处理单元)的崛起;而在处理超长文本推论时,大量生成的键值快取(KV Cache)则需藉由CPU、DPU、服务器专用RDIMM内存以及如日本铠侠(KIOXIA)的XL-FLASH或韩国三星(Samsung)的Z-NAND等超低延迟KV-cache专用SSD进行卸除与分流。更关键的是,在负责排程与工具执行的环节,大量依赖传统x86架构CPU搭配大容量RDIMM及小型压缩附加内存模块(SOCAMM)来承载非模型运算工作。这导致2026年上半年起,市场对RDIMM与服务器CPU的需求呈现猛烈上修,彻底颠覆了过往仅聚焦HBM的单一视角。
大模型商自研芯片掀新云浪潮 晶圆代价催化ASIC内部SRAM直球对决
在市场参与者结构上,许家源特别指出新兴大模型业者(Model Providers)引发的生态裂变。过去如OpenAI与Anthropic等AI大厂多半依赖微软、亚马逊等超大规模数据中心(Hyperscalers)采购算力;然而自2026年下半年起,这类模型巨头开始加速自建算力战场,争相发布自研ASIC芯片计划,例如OpenAI的Halapeño项目已完成测试并展开供应链召集,Anthropic亦全力跟进。这类新兴云端厂商(New Cloud)加入建置自研算力与后续配套通用服务器的行列,使内存原厂在HBM、RDIMM及服务器CPU的订单上迎来前所未见的增量动能。
与此同时,硬件架构解决方案亦出现极具震撼力的交叉变革。许家源揭露,近期如NVIDIA针对推论市场重新复活的Rubin CPX芯片架构,采用外挂SOCAMM与RDIMM模块设计;而更具颠覆性的趋势在于ASIC芯片内部架构的演进。受制于内存合约报价持续暴涨,以第四季RDIMM合约价格推算,一片12吋DRAM晶圆产出可为原厂创造高达8万美元的惊人营收,其单位价值已大幅超越台积电2奈米或3奈米的晶圆代工牌价。在极端经济效益的拉扯下,部分ASIC设计阵营选择跳脱外接昂贵且高延迟DRAM的框架,转而在芯片内部大幅扩增静态随机存取内存(SRAM)的配置面积,以极致的芯片内快取支持低延迟实时推论。这种将运算与内存深度融合的SRAM增配逻辑,正成为高带宽方案在特殊推论场景下的强劲竞争者。
核心数量激增超越服务器出货 2027年内存位面临结构性短缺
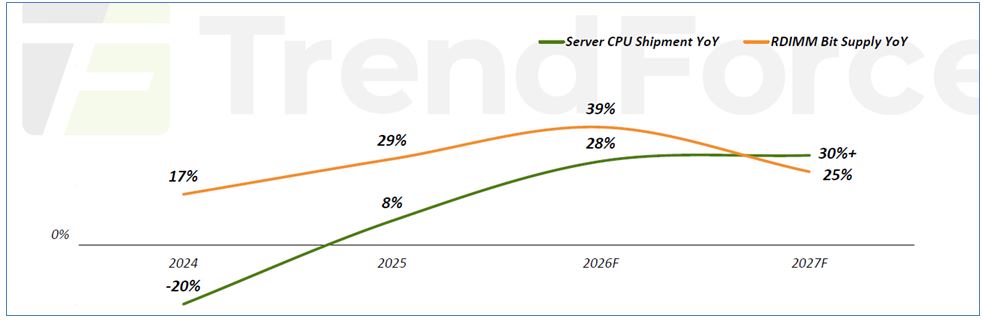
针对整体产业最为关注的供需平衡点,许家源直言,内存供给紧张格局将毫无悬念地一路延续至2027年。回顾历史数据,2024年全球服务器CPU出货受库存调整冲击而年衰退20%,彼时RDIMM位供给年增率仍达17%;2025年服务器出货重启回温、年增8%,带动RDIMM供给增长29%;进入2026年,服务器CPU出货预估大幅增长28%,原厂全力冲刺使RDIMM位供给攀升至39%的扩产高峰。
然而,供需天平将在2027年遭遇严重失衡。许家源以保守情境(Bear Case)预估,2027年全球服务器CPU颗数出货年增率至少落在30%以上;若以基准情境(Base Case)评估,年增率更将高达40%至45%,其中AMD与ARM架构处理器的成长动能将大幅超越均值。更致命的供需剪刀差在于运算核心数(Core Counts)的非线性膨胀:目前业界基准为单颗CPU核心需搭配8GB的DRAM,随着多核心趋势加速推进,服务器所需的内存位总量增速远远甩开CPU整机出货量。相较之下,2027年全球RDIMM位供给年增率却受限于制程转换瓶颈大幅减速至25%;即便将新导入的SOCAMM纳入计算,两者合计供给增长仅35%至40%,依然显著落后于服务器端40%至45%的实质需求位增幅。许家源总结,在当前的硬件瓶颈链条中,晶圆代工产能是限制CPU产出的首要瓶颈,而服务器DRAM更是整体科技产业「瓶颈中的瓶颈」。
北美巨头长约死锁产能 中国客户降容因应凸显市场强弱分化
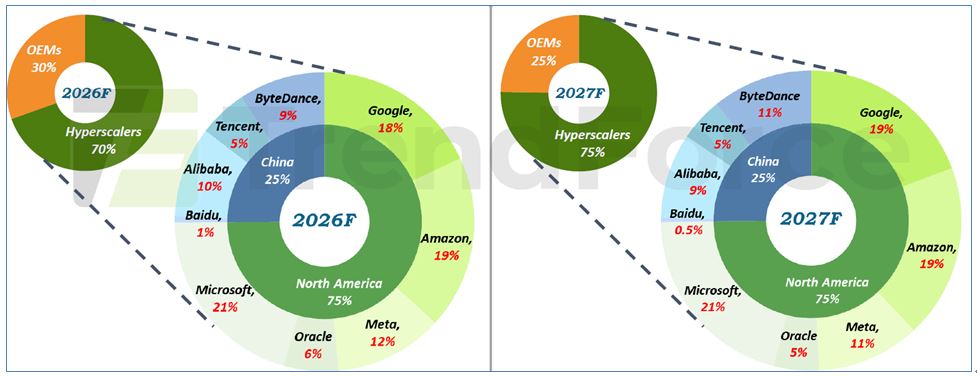
在全球数据中心采购格局上,需求呈现极度向北美寡占巨头倾斜的态势。集邦科技统计显示,2026年全球服务器DRAM采购版图中,超大规模业者(Hyperscalers)占比达70%,传统服务器品牌与代工厂(OEMs)占30%;至2027年,超大规模业者的比重将进一步扩大至75%,OEMs则被挤压至25%。在超大规模客户群体中,北美四大巨头(微软、亚马逊、Google、Meta)加上甲骨文合计高达75%,中国四大巨头(字节跳动、阿里巴巴、腾讯、百度)则占25%。许家源指出,光是微软一家的服务器DRAM采购总量,就足以超越全球所有个人计算机产业一年所消耗的DRAM位总和。
更值得密切观察的是美中两大市场在采购策略上的强烈对比。许家源透露,近一至两个月内中国市场出现了明显的需求乱流,以阿里巴巴为首的中国CSP,因服务器设计检讨而在大容量内存采购上出现显著的「降容、降规」现象。由于内存晶圆生产周期长达两个季度以上,原厂根本无法实时转产以迎合急转直下的中小容量规格,导致中国客户未提货的大容量DRAM只得全数转销至北美市场。反观北美市场,无论是微软、亚马逊、Google等老牌巨头,抑或是新兴云端厂商,整体服务器DRAM的供需满足率依然低于八成,市场释出的多余配额瞬间即被北美抢购一空。为防止未来断货,北美CSP正积极与三大原厂签署多年期长期供货协议,这使得原厂未来数年的高阶产能几乎被北美巨头全额锁定。
2027年制程微缩撞墙期加速无尘室扩建
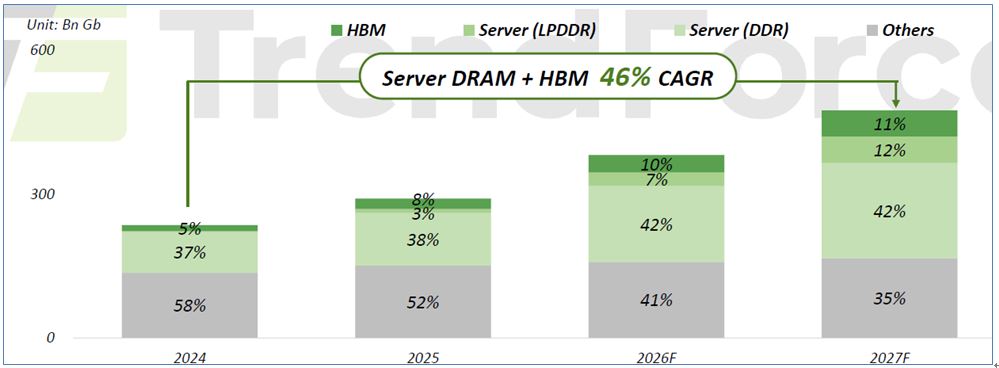
在原厂产能调配方面,高毛利率的服务器应用正形成巨大的吸力黑洞。集邦科技数据显示,自2024年至2027年,全球服务器DRAM与HBM合计位供给年复合成长率(CAGR)高达46%。在晶圆投片总量上,服务器相关应用占比已突破七成;若以产出位数计算,服务器DRAM加上HBM在2027年底前将占据全球总供给的65%(其中服务器标准DDR占42%、服务器LPDDR占12%、HBM占11%),而留给智能型手机、笔记本电脑及各类消费性电子的总体供给比重仅剩微薄的35%。消费性市场在供给端全面遭到极限边缘化。
针对原厂技术扩产路径,许家源分析,2026年全球DRAM位供给增长达31%,其中仅11%来自新晶圆投片扩张,其余高达20%全靠先进制程微缩(Process Migration)所贡献。然而,技术微缩的红利正迅速逼近物理极限。随着各原厂在2027年陆续推进至1c nm节点,制程升级所能挤出的位增益大幅缩水,使2027年位增长骤降至24%,市场步入制程撞墙期。许家源指出,要维持位供给增长,原厂必须重启实质的无尘室空间与新厂建设扩张,这波晶圆厂实体扩产潮预计将于2028年全面放量开出,届时位供给增幅方能重回25%以上水平。
DDR5传输速率推升与HBM4晶粒成本激增
在具体产品规格方面,服务器标准内存与HBM正全面倾向极致的高带宽技术方案。许家源指出,服务器DDR5正经历剧烈的速度世代交替:2025年下半年起,DDR5 6400 Mbps与前代5600 Mbps报价已正式打平(无价差),在同价加速效应下,6400规格迅速在2026至2027年完成主流市场渗透;与此同时,更高阶的7200与8000 Mbps规格则在2026下半年至2027年陆续上市的新处理器平台上呈现并行发展态势,例如AMD的Venice处理器主力导入8000 Mbps,而Intel的Clearwater Forest、AWS的Graviton以及微软Cobalt等芯片则倾向采用7200 Mbps。至2027年下半年,7200与8000各占一席之地,但两者合计市占率仍难以撼动6400的主导地位。然而在中国市场,因成本与能耗考虑,即便CPU已升级至支持7200或8000规格,客户端仍大量维持使用6400 Mbps,再次印证了区域技术落差。
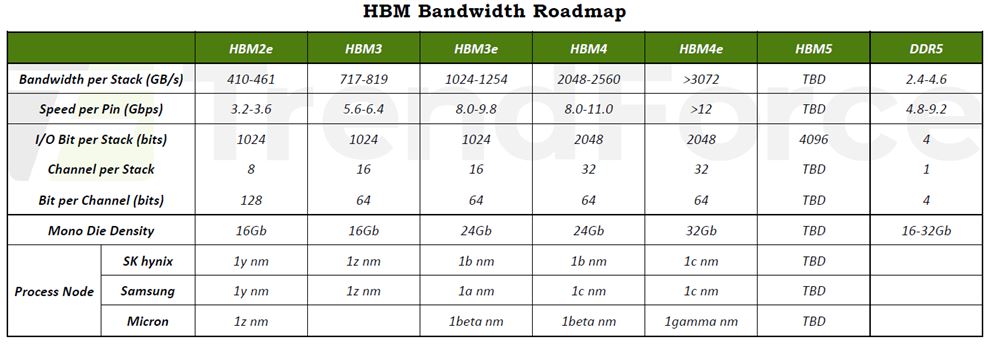
在支撑顶级算力的HBM领域,前段制程微缩与先进封装技术正迎来革命性突破。随着HBM4及次世代HBM4e标准确立,I/O位数由前代的1024 bits直接倍增至2048 bits,并首度导入32信道架构,单堆栈带宽自HBM3e的1024-1254 GB/s一举飞跃至2048-2560 GB/s以上,HBM4e更预计突破3072 GB/s大关。然而,带宽倍增的代价是前段硅穿孔(TSV)数量激增与后段凸块间距急遽微缩,导致HBM4与4e单颗裸晶(Die Size)尺寸相较前代大幅增加15%至20%,直接垫高了每Gb的生产成本。在三大原厂制程节点方面,SK海力士在HBM3e与HBM4采用1b nm,HBM4e转向1c nm;三星在HBM3e采用1a nm,HBM4与4e全押注1c nm;美光则在HBM3e与4深耕1beta nm,并规划于HBM4e推进至导入EUV的1gamma nm制程。技术突围与产能死锁,正全面重构全球半导体产业链的利润分配法则。
综观整体半导体产业发展,许家源归纳出两大关键核心结论:首先,分析当前及未来DRAM产业动态时,必须认清服务器应用早已占据绝对核心的主导地位,其晶圆投片与位消耗比重全面超越传统消费市场,成为牵动整体半导体景气荣枯的关键引擎。其次,服务器市场内部呈现深度的美中分化,北美无论是老牌超大规模巨头抑或是新兴云端厂商,需求强度持续大幅上修且全面追求高带宽规格升级;而中国市场则在降规降容与成本考虑下显露疲态。这股由Agentic AI引爆的结构性供给紧缩,在2027年结束之前将难以抚平,唯有掌握高带宽技术与稳定产能布局的企业,方能在此波算力浪潮中立于不败之地。
备注:
[1] 2026/10/28,巨亨网:内存涨价潮恐延续至2028年!TrendForce估HBM明年营收破2000亿美元
[2] 2026/10/29,TechInsights:Memory Market Outlook 2027: Five Trends Reshaping HBM, DRAM.
[3] 2026/9/29,TrendForce:反映HBM供应持续吃紧,上修2027年HBM价格展望、预估ASP年增达121%
[4] 2026/10/19,BigGo Finance:KeyBanc看2027年首季HBM价格翻倍,长约换约成涨价引爆点
[5] 2026/10/6,DIGITIMES:2027年HBM4涨价年增近2倍内存原厂进入全面「超额毛利」
数据源:
- 2026/11/5,集邦科技(TrendForce)「2027科技产业大预测」研讨会,资深分析师许家源简报。